
微调与 LoRA
区分 Prompt、RAG、Tool、LoRA 与全量微调,解释低秩更新、数据构造、评测和 Agent 项目落点。
微调与 LoRA
Agent效果不符合要求时,不应直接开始训练。需要先识别问题类型:输出契约不稳定时优化Prompt或Schema;事实频繁变化时使用RAG或Tool;稳定行为模式难以通过提示获得时考虑LoRA;仅在需要深层能力迁移且数据与算力充足时考虑全量微调。
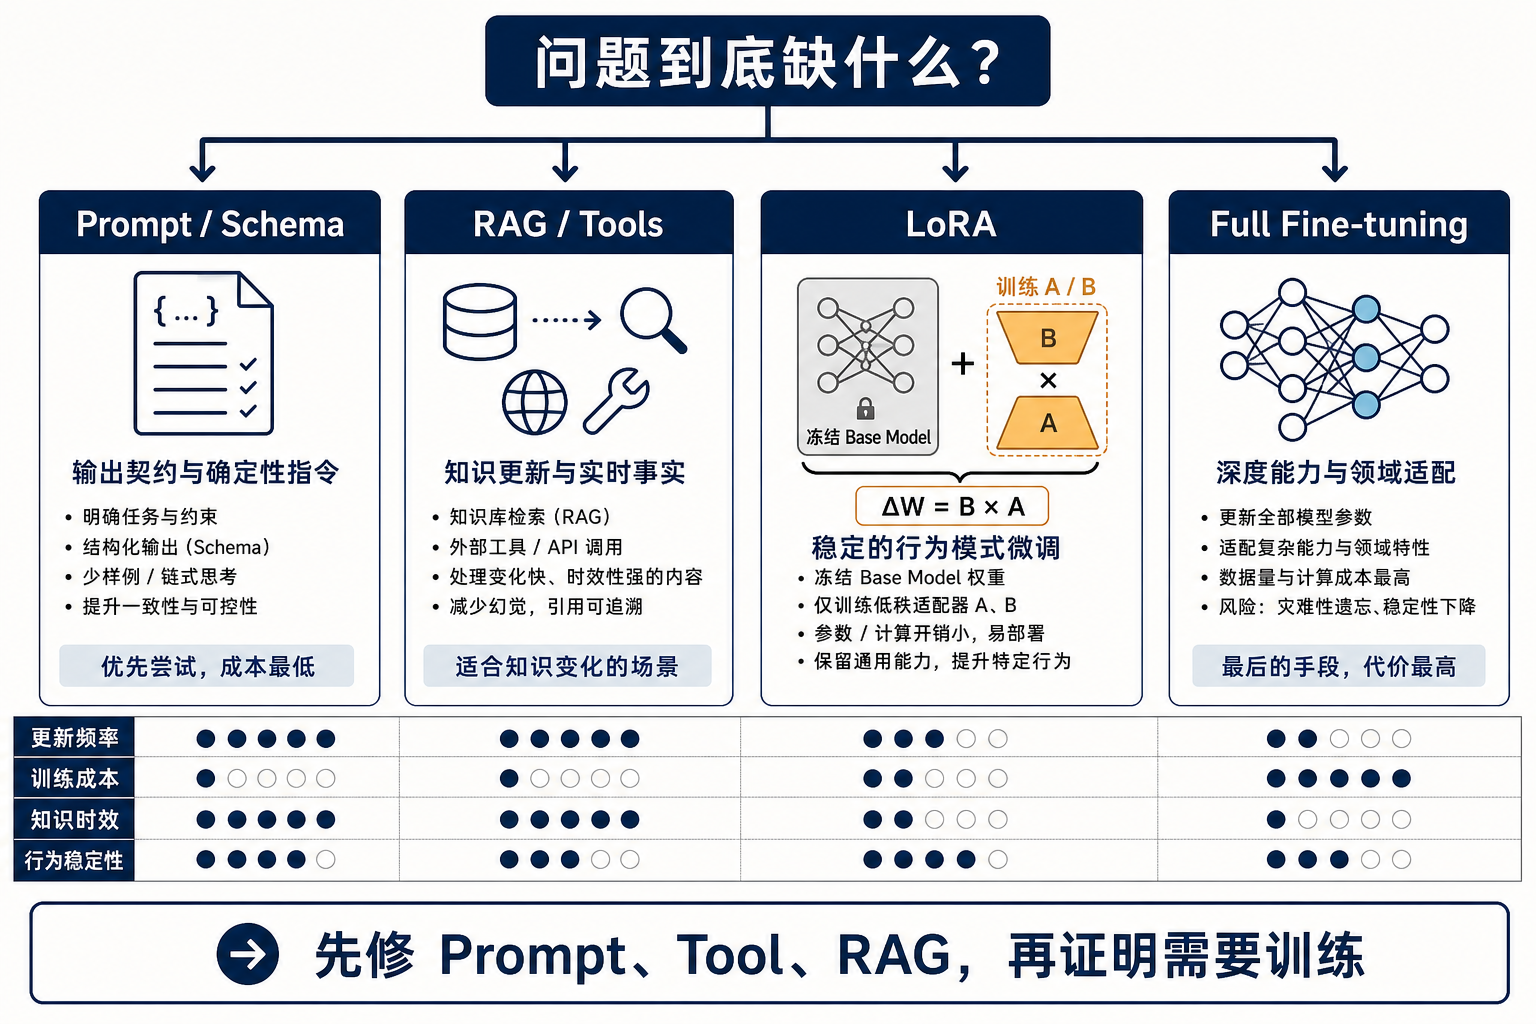
全量微调的参数更新范围
全量微调更新基础模型的大部分或全部参数,使模型整体适应新任务或领域。它的适配能力较强,但训练显存、数据量、优化稳定性、灾难性遗忘和部署成本也最高;为每个任务保存完整模型副本还会显著增加存储与发布成本。
它适合:
- 领域和通用语料差异巨大;
- 需要改变较深的语言或任务能力;
- 有规模足够、分布可信的数据;
- 有能力做完整对齐、安全和回归评测。
不适合拿来记每天变化的Runbook、价格、指标和服务拓扑,这些事实应由RAG或Tool提供。
LoRA的低秩参数化
对于原权重矩阵W₀ ∈ R^(d×k),LoRA冻结W₀,只学习低秩更新:
W = W₀ + ΔW
ΔW = B × A

A ∈ R^(r×k)
B ∈ R^(d×r)
r ≪ min(d, k)训练参数从d×k降为r×k + d×r。低秩假设认为任务适配所需的权重变化位于较低维子空间。通常还会使用缩放α/r和LoRA Dropout,并选择Attention或MLP中的特定线性层作为Target Module。
LoRA训练完成后可以独立保存Adapter,也可以Merge进Base Weight做推理。多个Adapter共享一个Base Model,部署与切换更轻;但并发加载、Adapter版本、合并精度和Serving框架支持仍要真实测试。
QLoRA的量化基础模型
QLoRA把冻结的Base Model以4-bit等低精度形式加载,梯度仍更新LoRA Adapter,从而进一步降低训练显存。常见关键点包括NF4量化、Double Quantization与高精度Compute Dtype。
量化主要降低Base Model的驻留和相关开销,不表示训练不再需要Optimizer State、Activation和Adapter Gradient。序列长度、Batch大小和Gradient Checkpointing仍会显著影响显存占用。
Agent场景中的适用范围
LoRA适合学习稳定的行为模式:
- 固定领域术语与表达;
- Tool选择模式与Argument结构;
- 稳定JSON / DSL输出;
- 意图分类和Workflow路由;
- Evidence充足时的结构化RCA写法;
- 特定设备或业务里的固定操作规范。
不适合:
- 每天变化的Runbook、事故事实和指标;
- Tool实时返回值;
- 租户私有知识;
- 通过简单Schema即可约束的格式问题;
- 数据只有几十条且错误不少的“高质量Trace据说”。
LoRA适合学习稳定行为,不适合存储频繁变化的Runbook知识。知识更新通常应通过RAG或Tool完成,而不是重新训练模型。
训练数据构造
AgentOps可以从高质量Trace构造:
Incident Context + Available Tools + Evidence
→ Correct Tool Call / Structured RCA
但不能将线上Trace未经处理直接用于训练:
- 删除失败、误操作和未复核样本;
- 脱敏Token、Cookie、用户数据与内部地址;
- 统一Tool Schema与版本;
- 将Argument、Observation和Final边界标清;
- 保留“证据不足时拒答”的负样本;
- 按Incident划分Train/Dev/Test,避免同一事故改写泄漏;
- 对危险Tool只训练提出Approval,不训练绕过Approval。
数据质量和覆盖通常比盲目增加Epoch更重要。重复训练错误Tool Call会使错误行为更稳定。
训练与超参数
LoRA核心超参数包括Rank r、Scaling α、Dropout、Target Modules、Learning Rate、Sequence Length和Batch策略。
- Rank太小可能容量不足,太大增加显存并可能过拟合;
- Learning Rate通常高于全量微调,但仍需Warmup和Dev监控;
- Target Module只选Q/V还是覆盖Q/K/V/O与MLP,需要按任务和预算实验;
- 长Agent Trace要考虑截断是否把Tool Result或Final切掉;
- Loss Mask应避免让模型学习无意义的系统模板或Observation文本预测。
LoRA效果验证
至少比较四条Baseline:
Prompt-only
Prompt + Better Schema / Tool
Prompt + RAG / Tool
以上方案 + LoRA
冻结Base Model、Dataset、Tool Response、MaxStep和Budget。评测:
- Tool Selection Accuracy;
- Argument Exact Match / Schema Pass Rate;
- Task Success与Root Cause Hit;
- Faithfulness与拒答;
- 无效调用、循环与MaxStep;
- 通用能力回归和灾难性遗忘;
- 安全拒绝、越权与Injection;
- Latency、吞吐、显存和Adapter切换成本。
如果Better Schema已经解决90%的格式错误,LoRA多拿1%却引入一套训练部署链,技术上能训不等于商业上该训。
部署与版本
需要固定并记录Base Model Hash、Tokenizer、Adapter Version、Training Dataset Snapshot、Prompt Version、Tool Schema Version和Quantization Config。Adapter与不兼容的Base组合可能不会立即报错,却会造成持续的质量退化,因此必须在加载时校验兼容关系。
上线走Canary,保留无Adapter或旧Adapter回滚。多租户Adapter必须按Tenant隔离并限制加载来源,不能让用户上传一个Adapter后顺便修改整个模型服务的行为边界。
项目回答模板
我们先区分知识问题、工具问题和行为问题:动态事实用RAG/Tool,结构不稳先修Prompt与Schema;只有稳定的工具选择或RCA格式仍长期不稳,才用LoRA。LoRA冻结Base Model,用低秩矩阵
ΔW=B×A训练少量参数,QLoRA再量化Base降低显存。训练数据来自专家复核并脱敏的Trace,按Incident切分;上线前与Prompt-only、RAG-only基线比较工具准确率、任务成功、安全回归、延迟与显存,并对Base、Adapter、Dataset和Tool Schema统一版本化。
高频追问
- LoRA的Rank增大带来什么收益和风险?
- LoRA Adapter Merge与动态加载各有什么取舍?
- QLoRA量化了什么,训练精度如何保持?
- 为什么动态知识应该进RAG而不是微调?
- Agent Trace做SFT数据为什么容易发生标签污染?
- 如何测灾难性遗忘和安全能力回退?