
Agent 架构
从受控行动循环出发,说明 Agent 核心组件、主流工具调用、思维链、ReAct 与多 Agent 编排难点。
Agent 架构
Agent不是简单的大模型循环。完整Agent需要目标、受控工具、可恢复状态、决策循环和停止条件。缺少持久状态会导致任务无法恢复;缺少停止条件会造成无界循环;缺少权限边界则可能产生越权副作用。
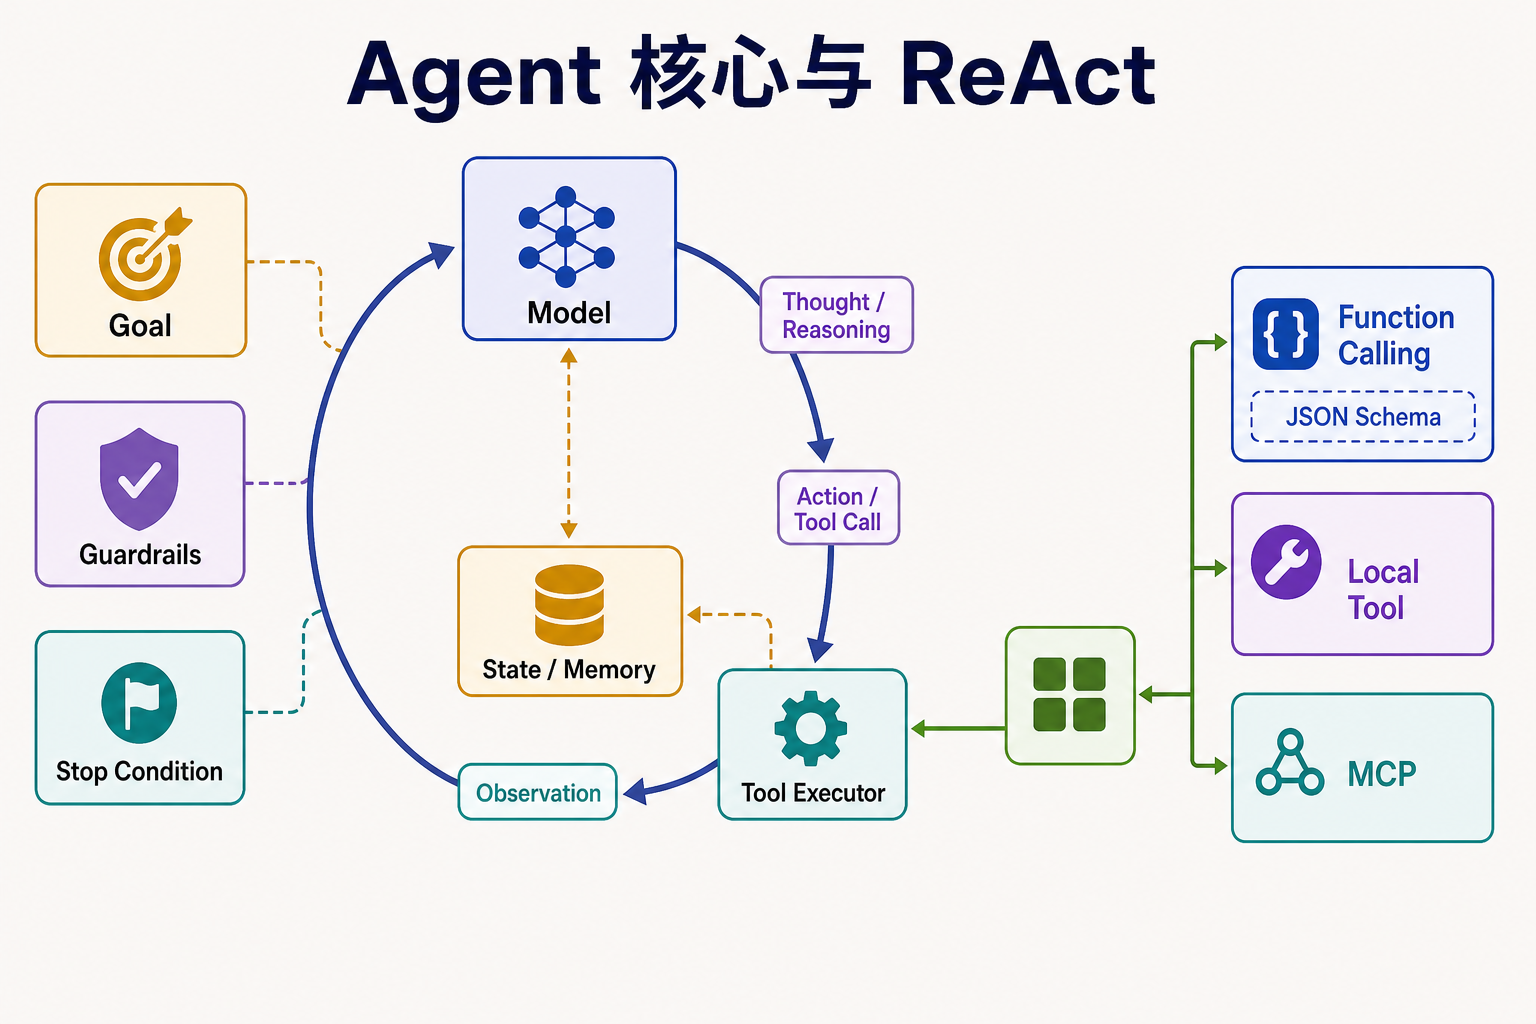
Agent核心组件及其职责
| 组件 | 作用 | 常见追问 |
|---|---|---|
| Goal / Instruction | 定义任务、输出契约、允许动作 | 冲突指令如何裁决 |
| Model | 理解上下文,产生计划、参数或答案 | 模型不可用如何降级 |
| Planner / Policy | 决定下一步Action | 规则、DAG还是LLM |
| Tool Registry | 描述受控能力与Schema | 权限是否按租户与角色收敛 |
| Executor | 校验并执行真实副作用 | Timeout、Retry、Idempotency、Approval |
| State / Memory | 保存会话、任务和恢复点 | Durable State不能只在Prompt里 |
| Retrieval | 提供知识和当前Evidence | ACL、Version、Citation |
| Guardrail | 输入输出、安全、策略判断 | 不能只依赖Prompt约束 |
| Orchestrator | 并发、路由、Budget、Cancel、Stop | 全局与子任务预算如何联动 |
| Trace / Eval | 回放、归因和回归 | 是否能解释一次外部写操作 |
Agent的核心是目标驱动的受控行动循环。Model负责提出下一步,Executor负责执行外部动作;权限、状态和审计必须由确定性机制管理,不能仅依赖自然语言提示。
主流工具调用方法
1. 原生Function / Tool Calling
请求中发送Tool Name、Description和JSON Schema,模型返回结构化Tool Call。服务端验证参数、鉴权、执行,再把结果作为Tool Message送回模型。适合OpenAI、Anthropic等主流模型API。
2. 框架本地Tool
Eino、LangGraph、Semantic Kernel等框架将本地函数包装为Tool,由Tools Node执行。优势是能够与Workflow、State、Callback和Retry机制集成;但框架完成编排连接并不意味着Timeout、Idempotency和权限配置天然正确。
3. MCP
MCP通过initialize协商能力,客户端用tools/list发现Schema,再以tools/call跨进程调用。适合跨语言、远程工具和生态复用。MCP解决协议标准化,不替代后端鉴权、租户隔离、Egress Policy和审批。
4. 固定Workflow / DAG
调用顺序由代码确定,模型只负责特定节点。高风险且流程稳定的场景通常适合这种方式:模型负责内容判断,状态迁移和副作用边界由确定性代码保证。
5. 规则路由 + LLM Fallback
INTRO、CANCEL、RESUME等高频明确意图走确定性规则,复杂语义再交模型,降低成本和随机性。
Function Calling负责让模型按照Schema产生调用请求;本地Tool由框架中的Executor实际执行;MCP定义跨进程的工具发现与调用协议。模型生成的JSON本身不会产生副作用,只有受控Executor能够执行外部动作。
Tool的设计约束
每个Tool至少定义:
- 窄输入Schema,拒绝任意URL、Shell或SQL;
- 稳定Output与Error Code;
- Timeout、Retry Policy和最大Response;
- Read / Write / Delete / Send副作用级别;
- Idempotency Key或Dry Run;
- Tenant、User、Resource Scope;
- 是否需要Human Approval;
- Trace Redaction与审计字段。
query_metrics(service, range, promql_template)比http_get(url)安全,restart_service(service_id, expected_version, dry_run)比run_command(command)可审计。工具Verb越窄,Policy越能讲人话。
思维链与复杂推理
Chain-of-Thought描述模型在生成最终答案前形成中间推理步骤。其价值来自任务分解:模型可以逐项检查约束、分步计算,并在发现证据缺口后调用工具;Self-Consistency还可以比较多条候选推理路径。
工程上不依赖、展示或持久化冗长隐藏推理。应该保存的是可审计的外显产物:
Plan
Tool Call
Observation
Evidence Citation
Validation Result
Final Answer
这样既保留问题分解与校验的收益,也避免将不可验证的隐藏推理当作证据。AgentOps中的Evidence Board和Trace承担可审计中间状态的职责。
ReAct执行模式
Reasoning:根据现有证据判断缺什么
→ Action:产生结构化 Tool Call
→ Executor:鉴权、校验并执行
→ Observation:真实工具结果进入上下文
→ Reasoning:继续、改路或停止
→ FinalEino中ChatModel产生tool_calls后进入ToolsNode,按Name找到Tool并执行,再把Tool Message送回下一轮。没有Tool Call、达到MaxStep、Budget耗尽或命中业务Stop Condition时结束。
ReAct的核心是“识别证据缺口 → 调用工具 → 接收真实Observation → 根据新证据继续决策”。字段是否命名为Thought并不重要;Observation必须来自受控工具或外部环境,不能由模型自行生成。
必须设置:MaxStep、Deadline、Token/Cost Budget、Tool Allowlist、Response Truncation、重复调用检测、Cancel和人工审批。
多智能体系统的工程难点
多智能体并不等同于简单增加多个模型实例。每增加一个Agent,都会引入新的状态一致性、预算、权限和错误传播问题。拆分必须带来明确收益,例如并行执行、权限隔离、上下文隔离或专业能力划分。
1. 任务边界
职责重叠会重复查同一工具,切太碎又把Token花在互相复述。AgentOps按Evidence Domain拆成Metrics、Logs、Experience,而不是每个函数封一个Agent。
2. 共享状态
不同Agent必须使用同一个Incident Snapshot、Time Range与Evidence Version。共享的是结构化Evidence和Pointer,不是把所有聊天记录互发一遍。
3. 冲突裁决
Metrics说CPU,Logs说Timeout,History说连接池,Synthesizer不能投票决定真理;应按照来源质量、时间窗口、因果链和交叉验证裁决,并在证据冲突时明确输出不确定性。
4. 并发与依赖
Metrics与Logs可固定并行;Experience是否执行由Planner根据第一轮证据触发;Synthesizer等待必要Evidence。盲目并发会让下游在缺数据时先编一个结论占座。
5. 错误与停止
子Agent输出要带status / confidence / evidence_ids / error,下游不能把失败摘要当事实。子Agent和全局分别有Step、Latency、Token和Cost Budget;Orchestrator负责Cancel传播与最终收敛。
6. 权限
Metrics Agent只拿只读监控工具,Remediation Agent才可能拿写工具,并要求Approval和Dry Run。多Agent不是扩权理由,反而更需要Least Privilege。
AgentOps编排回答模板
我们没有让多个Agent自由聊天,而是用Orchestrator管理分阶段取证。Metrics和Logs第一轮并行,Planner根据Evidence缺口条件触发Experience;Agent通过共享Evidence Board传递结构化证据和Pointer,Synthesizer单点裁决。每个Agent有独立Tool Allowlist与Budget,输出包含状态、来源和置信度;全链路用Trace ID复盘并发顺序、Tool Call和最终Citation。
高频追问
- Tool Calling和MCP的关系是什么,谁真正执行副作用?
- 为什么Schema校验不能替代业务鉴权?
- ReAct怎样避免重复调用和无限循环?
- 为什么不应该保存模型隐藏CoT,应该保存什么?
- 多Agent何时比单Agent + Workflow更差?
- 子Agent失败后Orchestrator如何决定降级、重试或终止?