
PostgreSQL
沿一条 UPDATE 的数据路径拆开 PostgreSQL 的进程模型、MVCC、WAL、Checkpoint、VACUUM、隔离级别与复制。
PostgreSQL
理解PostgreSQL时需要先区分职责:MVCC负责可见性,WAL负责崩溃恢复,Shared Buffers负责缓存Page,VACUUM负责处理不再对任何活跃快照可见的旧Tuple。这些机制相互协作,但解决的问题不同。
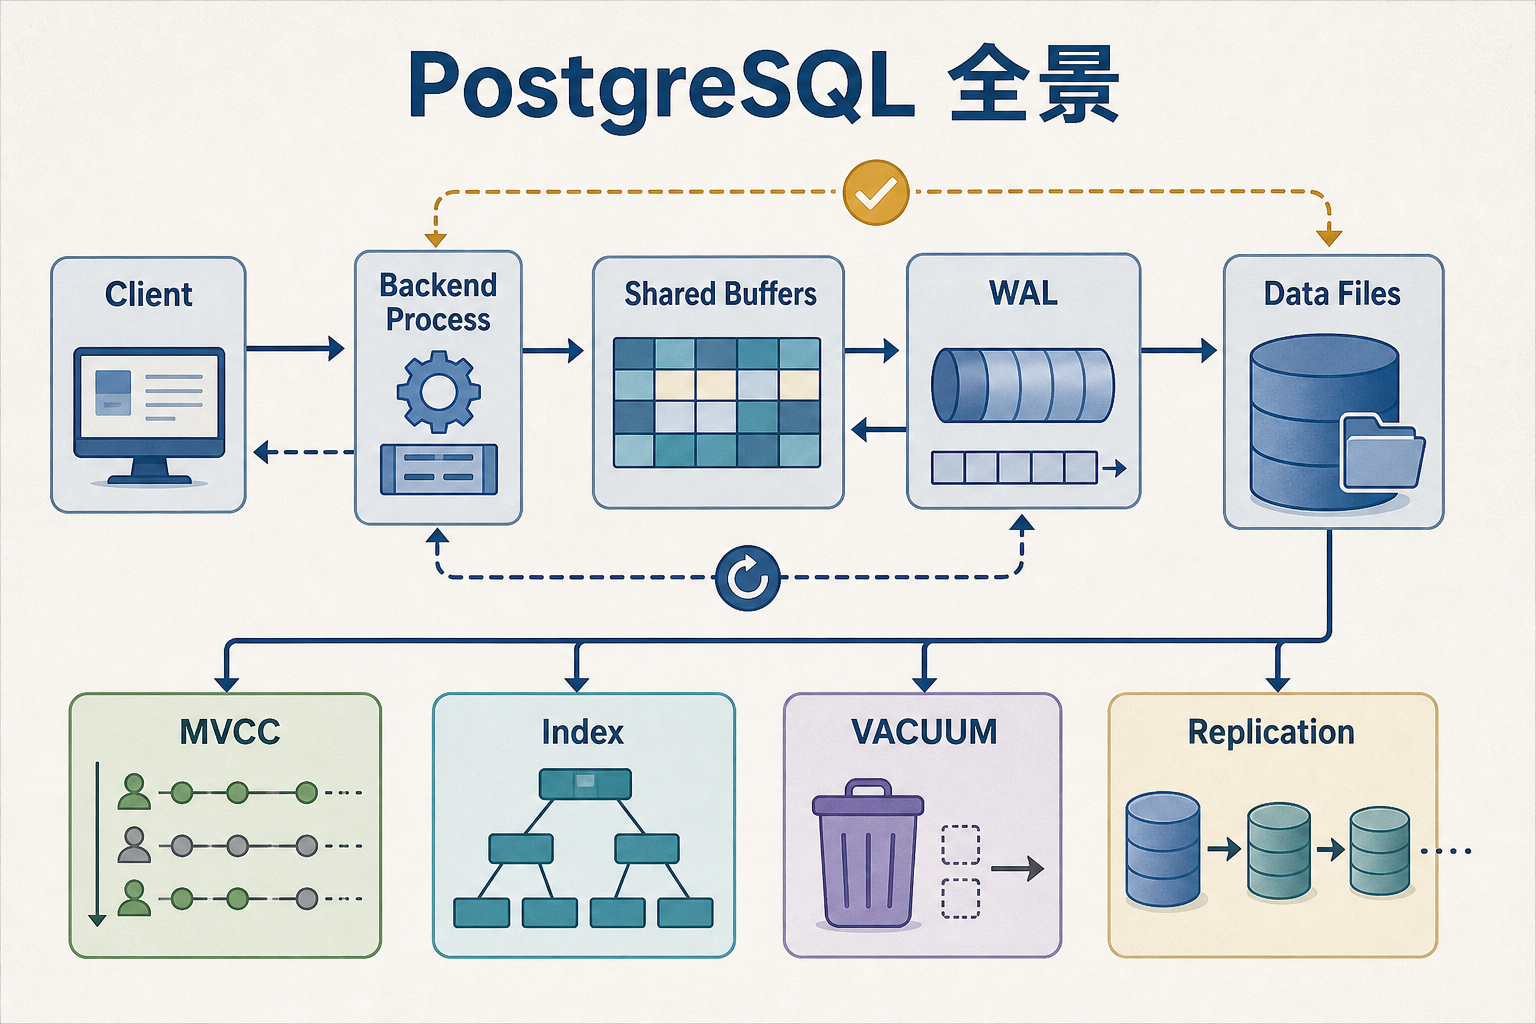
UPDATE的数据路径
Client
→ Backend Process
→ Parse / Plan / Execute
→ Shared Buffers 中定位 Page
→ 旧 Tuple 写 xmax,新 Tuple 写 xmin
→ 生成 WAL Record
→ COMMIT 等 WAL flush
→ 脏页随后由 Checkpointer / Background Writer / Backend 写回
PostgreSQL通常为每个客户端连接分配一个Backend Process。UPDATE一般不是原地覆盖Tuple,而是使旧版本失效并创建新版本,同时生成WAL。提交时不要求Data Page已经落盘,但在默认同步提交语义下,要求相关WAL先到达稳定存储,这正是Write Ahead原则。
MVCC:Snapshot与Tuple可见性
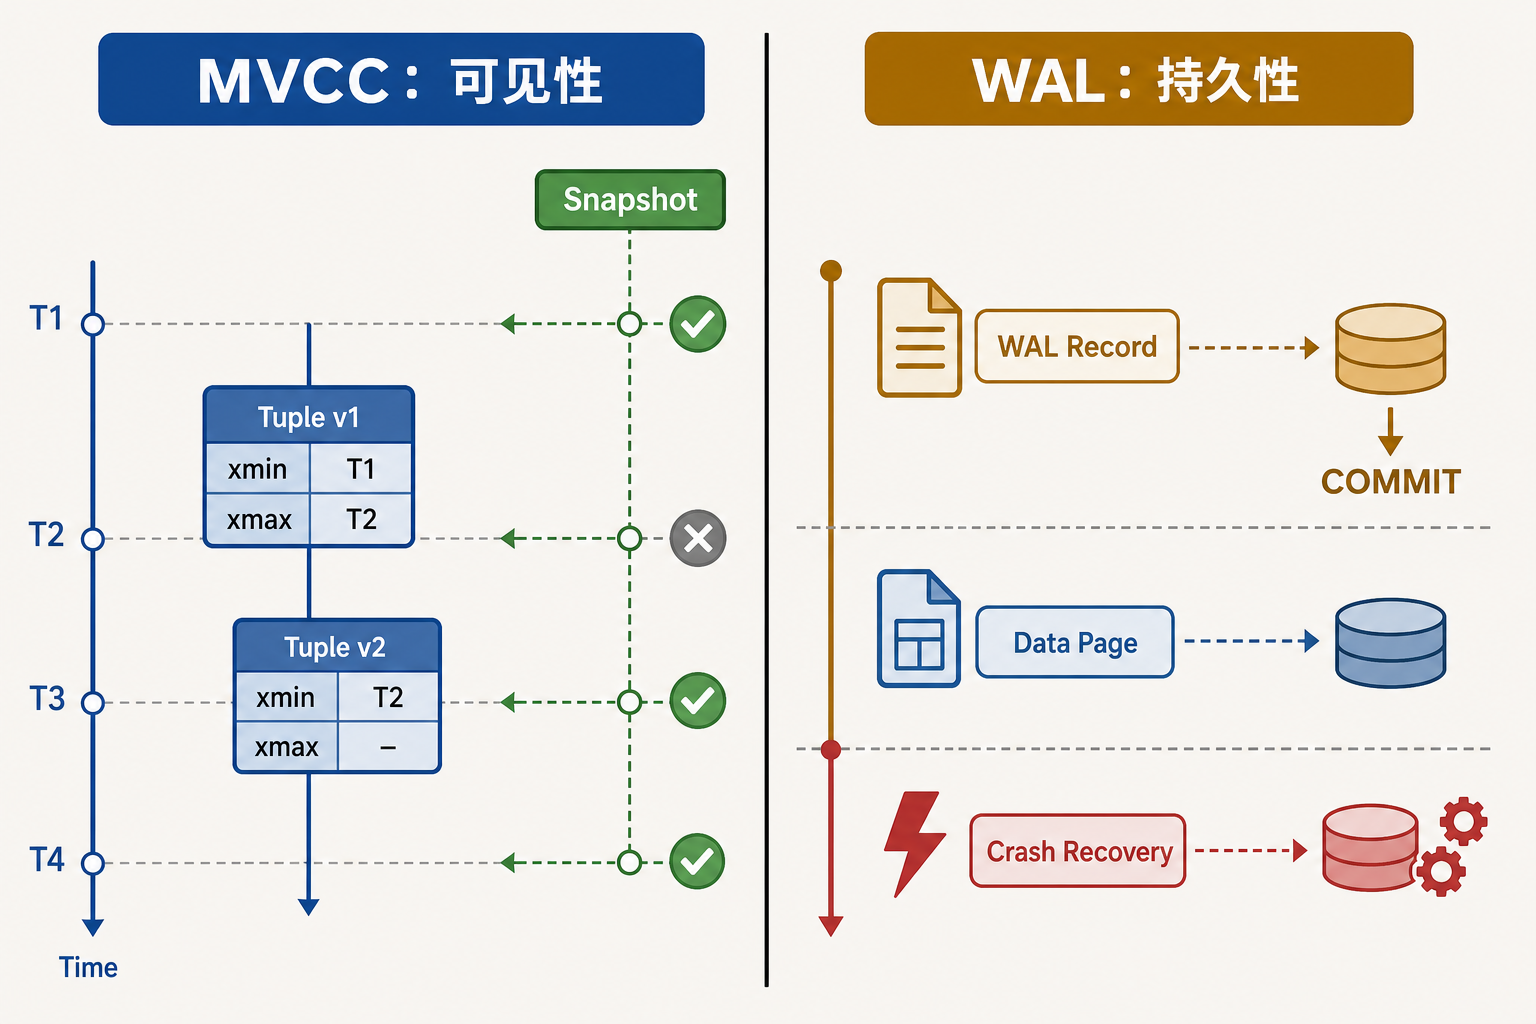
Tuple Header里的核心字段可以这么讲:
xmin:创建这个版本的事务ID;xmax:删除或替换这个版本的事务ID;- Snapshot:当前语句或事务已知的活跃、已提交事务边界;
- Visibility Map:Page是否全部可见、是否全部冻结的辅助信息,不代替Tuple可见性规则。
普通读写较少相互阻塞,并不表示PostgreSQL没有锁;原因是读事务可以根据Snapshot读取合适的旧版本,不必等待写事务完成。其代价是旧版本必须由VACUUM在满足回收条件后处理。
Read Committed 与 Repeatable Read
Read Committed通常为每条语句取得新Snapshot,因此同一事务中的第二次查询可能看到其他事务刚提交的数据。Repeatable Read复用事务级Snapshot,使读取视图保持稳定,但仍需区分“读取稳定”和“业务约束安全”。
经典Write Skew是两个事务基于同一快照读取跨行条件,然后分别更新不同的行;两个写集合没有直接冲突,但组合结果破坏了业务不变量。需要数据库检查可串行化依赖时使用Serializable,并准备捕获serialization_failure后重试。Serializable会引入可预期的事务失败,应用层必须实现重试协议。
WAL:提交成功究竟承诺了什么
WAL先记录恢复所需的变化,再允许脏页落盘。崩溃后从Checkpoint附近开始Redo,把已经持久化到WAL、但尚未反映到data files的变化重放回来。
需要拆开三个动作:
WAL write:WAL进入操作系统缓存;WAL flush:WAL抵达稳定存储边界;data page flush:脏页后来写回表文件。
默认同步提交语义下,事务返回成功主要依赖对应WAL已经Flush,而不是所有脏页已经写完。若每次事务都等待相关数据页落盘,随机I/O和写放大会显著降低吞吐。
Checkpointer、Background Writer 与 Backend
- Checkpointer建立恢复起点,并推动Checkpoint要求的脏页写回;
- Background Writer平滑写出部分脏页,减少Backend临时找不到可复用Buffer的概率;
- Backend在压力下也可能自己写脏页;
- WAL Writer负责推进WAL写出。
将这些组件统称为“刷盘线程”既混淆职责,也不符合PostgreSQL的多进程模型。
VACUUM:推进Tuple可回收边界
VACUUM根据全局最老Snapshot等信息判断哪些旧Tuple不再可能被任何事务看见,然后将空间标记为可复用,并维护Visibility Map。普通VACUUM通常不会将文件末尾空间直接归还操作系统;VACUUM FULL会重写表并持有更强的锁,不适合作为常规维护手段。
长事务会长期保留旧Snapshot,导致Dead Tuple无法回收;复制槽若长期不推进,也可能导致WAL持续积压。排障时除AutoVacuum配置外,还要检查:
pg_stat_activity中的长事务与idle in transaction;n_dead_tup、表膨胀与AutoVacuum阈值;- Transaction ID年龄与Freeze进度;
- Replication Slot保留的WAL;
- Checkpoint频率和写放大。
Index Only Scan与Heap访问
即使索引已经包含查询列,PostgreSQL仍需判断Tuple可见性。若Visibility Map将对应Heap Page标记为All-visible,Executor可以跳过Heap访问;否则仍需回表确认。因此Index Only Scan能否避免Heap访问会受到VACUUM进度影响。
复制、选主、切流是三件事
Streaming Replication把主库WAL传给Standby重放。同步复制可以把提交确认延伸到指定Standby,但具体等到write、flush还是apply由配置决定。它仍不自动解决:
- 谁判断主库真的失效;
- 谁提升新主;
- 客户端DNS、VIP或连接池如何切过去;
- 旧主恢复后如何避免双主;
- RPO、RTO分别接受多少。
因此,Streaming Replication只提供数据复制链路,不能单独完成故障检测、选主、防止双主和客户端流量切换。
项目回答模板
我们把数据库正确性拆成可见性、持久性和高可用三个边界。行更新通过MVCC保留Tuple版本,Snapshot决定读取可见性;提交依赖WAL先持久化,脏页异步写回;AutoVacuum负责回收旧版本并推进Freeze。主从通过WAL复制,但故障检测、选主和连接切换另由HA组件负责。监控上重点看长事务、Dead Tuple、Checkpoint、WAL生成速率、Replication Lag和Slot滞留。
高频追问
UPDATE为什么造成表膨胀,HOT Update什么时候减少索引写放大?fsync、synchronous_commit、full_page_writes分别保护什么?- Checkpoint过密为什么带来I/O尖峰,过疏又为什么拉长恢复时间?
- Repeatable Read为什么仍可能出现Write Skew?
- 长事务、复制槽和VACUUM之间怎样互相伤害?
- 同步复制返回成功,是否表示业务已经完成跨服务事务?否。PostgreSQL同步复制只约束数据库复制确认边界,不能保证数据库之外的跨服务事务完成。