
Redis
拆开 Redis 的事件循环、底层编码、RDB/AOF、复制、Sentinel、Cluster、Cache-Aside 与分布式锁。
Redis
将Redis的性能简单归因于“单线程”并不充分。需要分别分析核心命令执行、网络I/O、对象编码、持久化、复制、故障转移和缓存一致性。
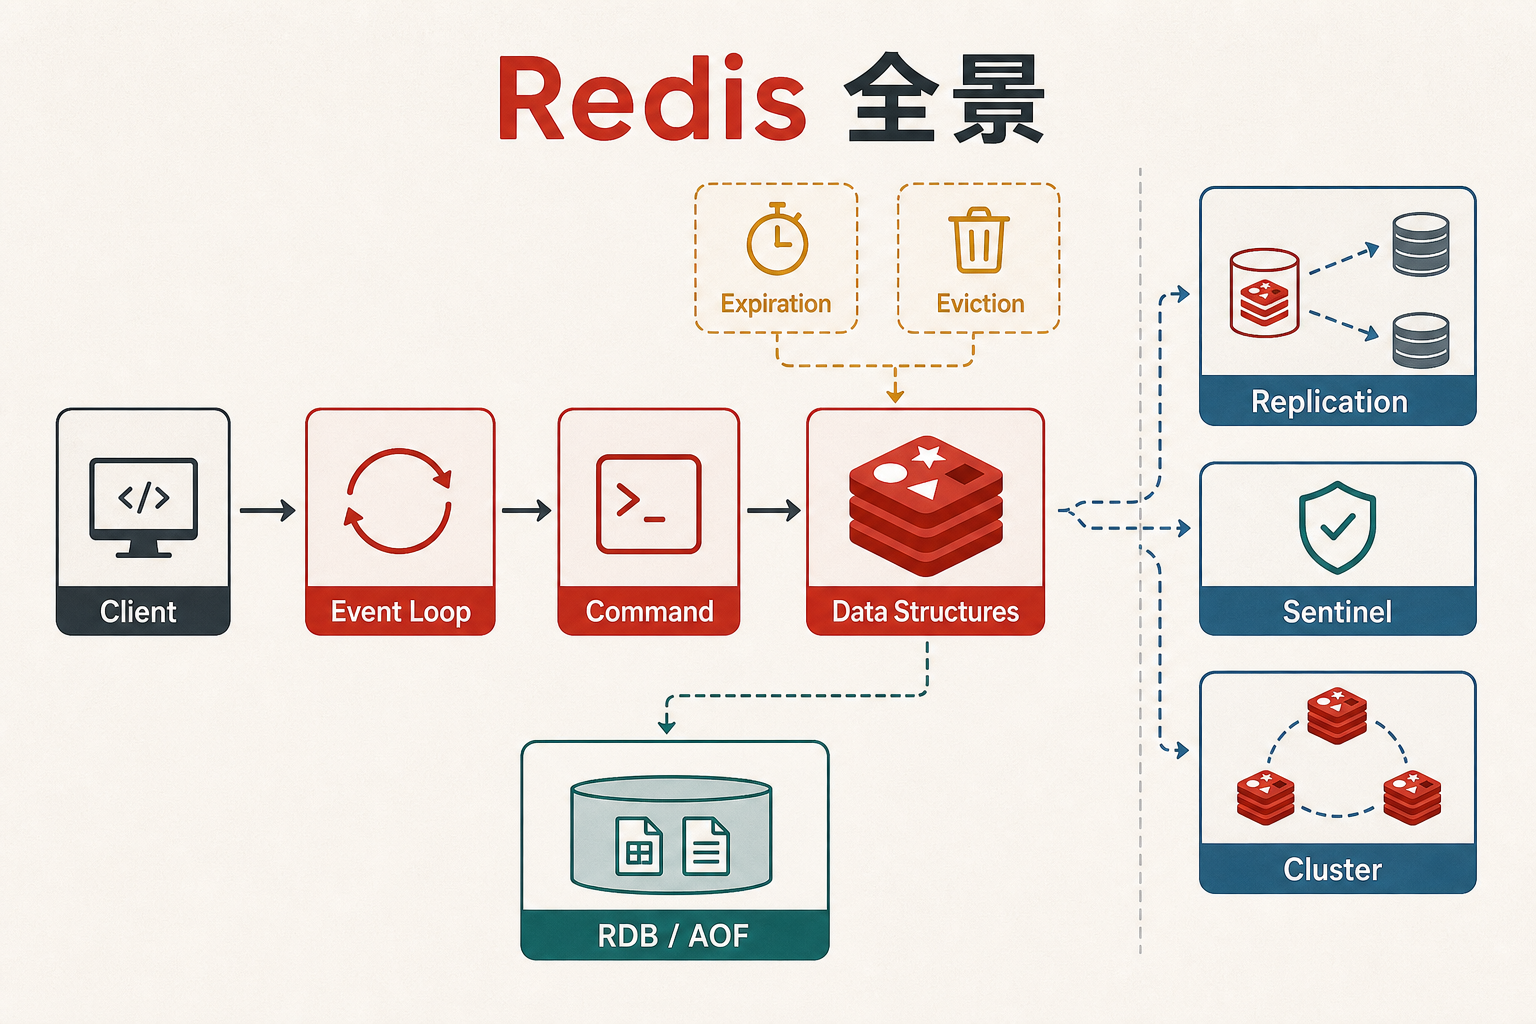
Redis的性能来源与阻塞点
Redis核心命令通常由Event Loop串行执行,单条命令因此天然拥有原子执行边界,也省去共享数据结构上的大量锁竞争。部分版本支持多线程网络I/O,但命令执行是否串行要按照版本和配置说明,不能背成“Redis永远只有一条线程”。
快来自一组共同条件:
- 数据主要在内存,随机访问延迟低;
- I/O Multiplexing用少量线程照看大量连接;
- 紧凑编码提高Cache Locality并减少内存;
- 命令实现大多有明确复杂度,避免不必要阻塞;
- 渐进式Rehash把扩容工作摊到多次操作。
Event Loop串行也意味着大Key、慢Lua、KEYS和大范围集合运算会阻塞后续命令。Fork、写时复制、AOF Rewrite、过期风暴、网络带宽和Swap同样可能成为性能瓶颈。
数据类型与底层编码
Redis对外类型和内部Encoding不是一一对应:
| 类型 | 常见编码思路 | 转换原因 |
|---|---|---|
| String | int / embstr / raw | 数字、小字符串、大字符串占用不同 |
| List | Quicklist组织Listpack | 兼顾紧凑存储与两端操作 |
| Hash | Listpack → Hashtable | 小对象省内存,大对象稳定查找 |
| Set | Intset → Hashtable | 纯整数小集合更紧凑 |
| Sorted Set | Listpack → Skiplist + Dict | 同时满足按member查分数和按score排序 |
阈值会随版本与配置变化。更可靠的理解是:数据规模较小时使用紧凑编码,规模增长后切换为具有稳定复杂度的数据结构。Redis Object还包含类型、编码、LRU/LFU相关信息和引用计数等元数据。
过期与淘汰的区别
TTL到期表示Key逻辑上不应再被返回,Redis通过惰性删除与定期抽样删除组合清理;Maxmemory Eviction则是在内存达到上限时按照策略选择牺牲品。一个管时间语义,一个管容量压力。
企业配置需要明确:
- 是否允许无TTL的Key被淘汰;
- 使用LRU、LFU、Random还是TTL倾向策略;
- 业务能否承受缓存击穿后的回源洪峰;
- 删除大对象是否使用异步free路径;
- Hot Key与Big Key如何发现和拆分。
RDB、AOF 与混合持久化
RDB生成某一时点的数据快照,恢复快、文件紧凑,但两次快照之间存在数据窗口;AOF记录写命令,配合appendfsync always/everysec/no在持久性与延迟之间取舍,文件增长后需要Rewrite;混合持久化常用RDB格式作为AOF重写基底,再追加增量命令,兼顾恢复速度与数据窗口。
Fork创建子进程时会共享父进程Page,后续写入触发Copy-on-Write。数据集较大且写流量较高时,持久化后台任务仍会增加前台进程的内存占用和页复制开销。
持久化决定节点重启后可以恢复哪些数据;主节点故障后的自动切换则由复制和高可用机制负责,两者解决的问题不同。
Replication、Sentinel 与 Cluster
Replica通过全量同步或PSYNC部分重同步追赶Master。Replication ID、Offset和Backlog共同判断断线副本能否从历史缓冲继续;落后超过Backlog覆盖范围就要重新全量同步。
Redis复制通常是异步的,Master返回成功时Replica可能尚未收到数据。故障转移期间仍可能丢失最近写入,因此存在多个副本并不等同于RPO为零。
- Sentinel:监控主从、主观/客观下线判断、选新主和通知客户端;解决的是不分片主从集群的故障转移;
- Cluster:16384个Hash Slot分片到多个Master,客户端处理
MOVED、ASK和拓扑刷新;解决容量与水平扩展,也带来迁槽、多Key跨槽和故障转移复杂度。
Cache-Aside的一致性边界
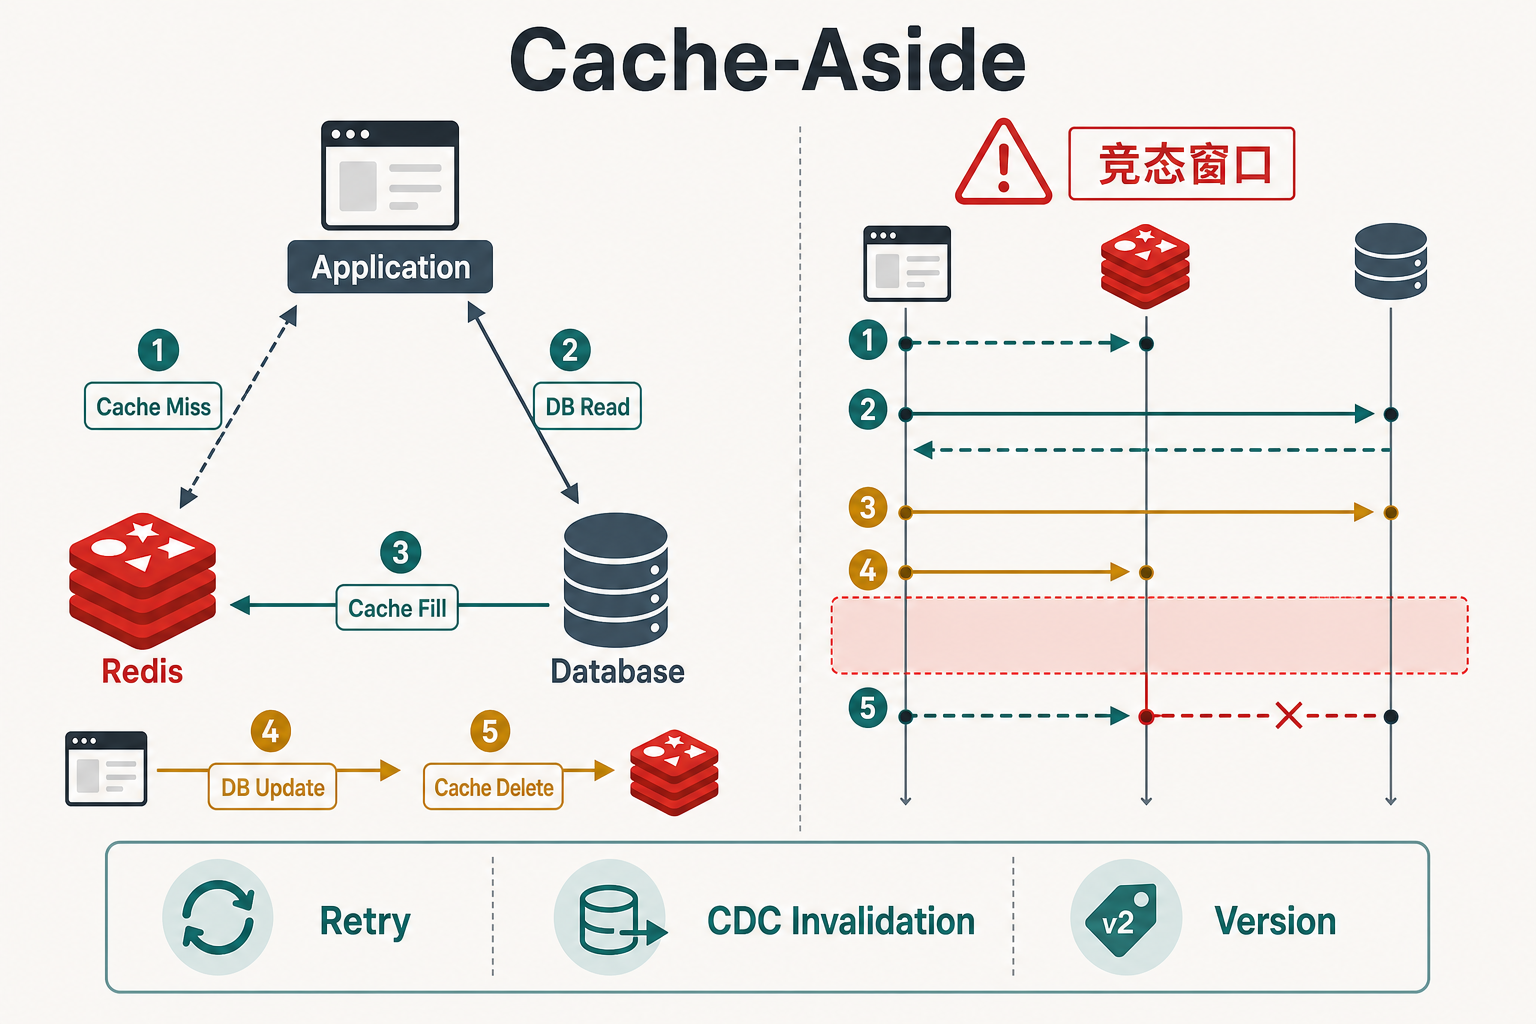
常见读路径为Cache Miss → 查询DB → 回填Cache;常见写路径为先更新DB → 再删除Cache。该模式能够降低不一致概率,但本身不提供Strict Consistency,仍需处理并发读写、删除失败和延迟窗口。
经典竞态:
R: Cache Miss
R: 从 DB 读到 v1
W: DB 更新为 v2
W: 删除 Cache
R: 把旧值 v1 回填 Cache
最终,已经删除的旧值被重新写入缓存。延迟双删可以缩小该窗口,但等待时间依赖真实请求耗时,不能构成严格一致性保证。更可靠的方案包括:
- 缓存值带Version,拒绝旧Version覆盖;
- DB提交后通过CDC/Outbox统一发失效事件;
- 对强一致读绕过缓存或读取权威源;
- Singleflight/互斥重建防止击穿;
- TTL作为最终自愈边界,但不能提供实时一致性。
缓存穿透、击穿与雪崩
- 穿透:请求的数据根本不存在,每次都绕过缓存打DB;可用参数校验、短TTL空值、Bloom Filter;
- 击穿:单个热点Key过期,大量请求同时回源;可用互斥重建、逻辑过期、提前刷新;
- 雪崩:大量Key同时失效或Redis整体不可用;可用TTL抖动、多级缓存、限流降级和隔离。
三者都可能表现为数据库回源流量上升,但触发条件和处理方法不同。
分布式锁与Fencing Token
SET key value NX PX ttl配合Lua比较Value后删除,可以避免误删其他客户端持有的锁。但客户端持锁后若暂停时间超过TTL,锁会被另一客户端获得;旧客户端恢复后仍可能向下游写入。锁服务中的租约已失效,但下游资源无法仅凭该租约识别迟到请求。
Fencing Token为每次成功获取锁分配单调递增编号,下游只接受比已处理Token更新的操作,从资源侧拒绝旧持有者的迟到请求。锁的租约必须与下游资源的写入保护关联,否则已经过期的锁持有者仍可能执行写入。
项目回答模板
Redis核心命令由Event Loop串行执行,网络I/O可按版本启用多线程。我们将RDB/AOF用于节点恢复,将Replication/Sentinel用于高可用,将Cluster用于分片,并分别设计三类机制。缓存采用Cache-Aside,数据库作为权威数据源;写入数据库后删除缓存,并通过CDC失效通知和Version防止旧值回填。热点Key使用Singleflight,TTL加入随机抖动。分布式锁仅用于协调,关键写入由下游Fencing Token保证顺序有效性。
高频追问
- Big Key为什么同时伤网络、Event Loop、复制和持久化?
- AOF
everysec最坏可能丢多少,为什么不是绝对一秒? - PSYNC什么时候退化成全量同步?
- Sentinel的主观下线和客观下线有什么区别?
- Cluster迁槽期间
MOVED与ASK分别表示什么? - 为什么Redlock也不能替代下游Fencing?