
数据系统
PostgreSQL、Kafka、Redis 与 RAG:四条独立的数据路径。
目录 · 4 节
数据系统
PostgreSQL、Kafka、Redis与RAG属于不同类型的系统,但都需要回答四个问题:数据从何处进入,经过哪些中间状态,成功条件是什么,故障后如何恢复或重新建立正确状态。
数据库可见性、消息复制、缓存一致性和检索证据分别具有独立的数据路径与失败边界,因此拆分为四篇文章:
PostgreSQL
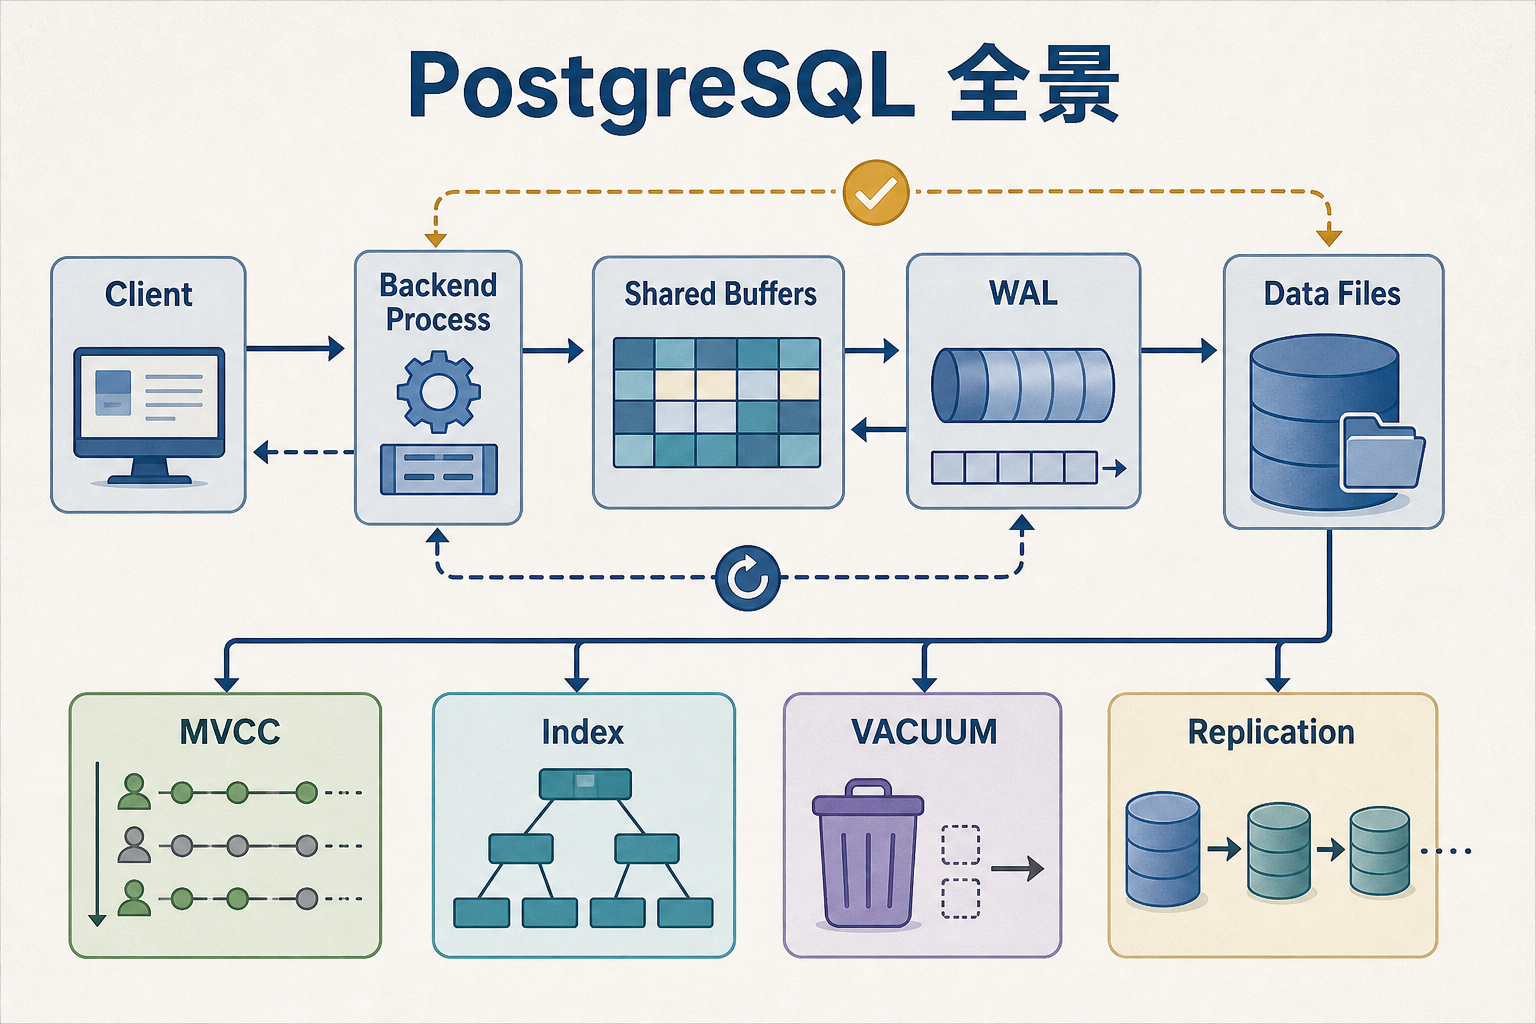
沿一条UPDATE拆开Backend Process、Shared Buffers、Tuple Version、Snapshot、WAL、Checkpoint和VACUUM;再把隔离级别、Write Skew、Index Only Scan、同步复制与故障切换接回同一条线。
Kafka
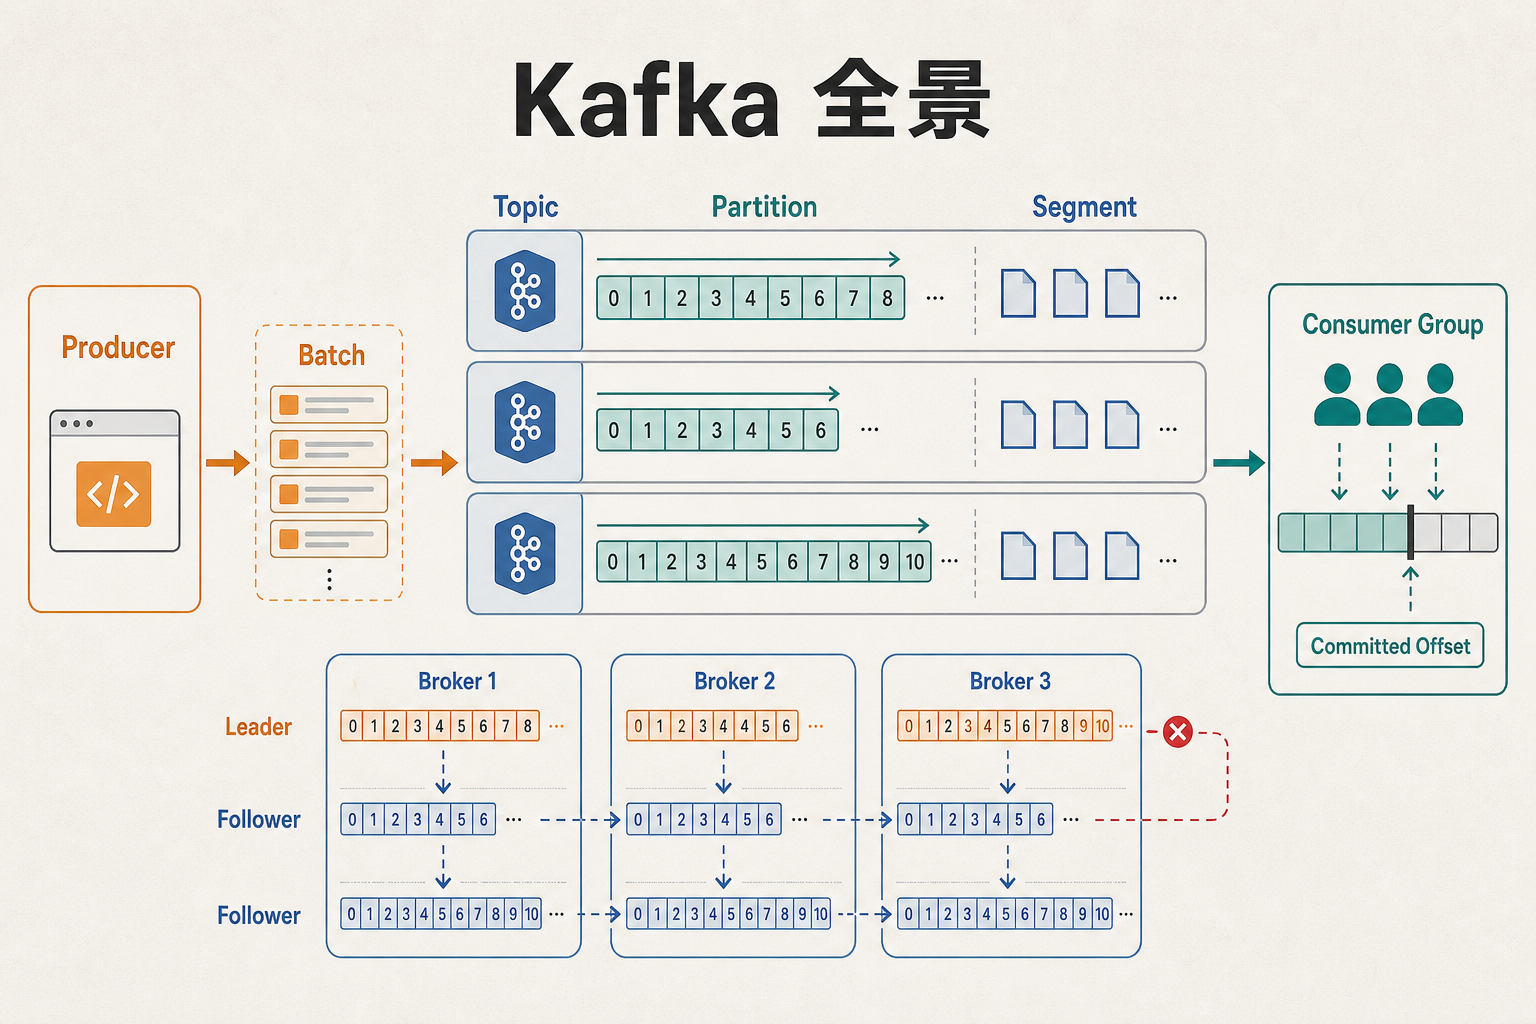
从Record Batch写进Partition开始,经过Segment、ISR、LEO/HW、Consumer Group、Rebalance和Committed Offset,最后收束到Exactly-Once究竟只exactly在哪堵墙里面。
Redis
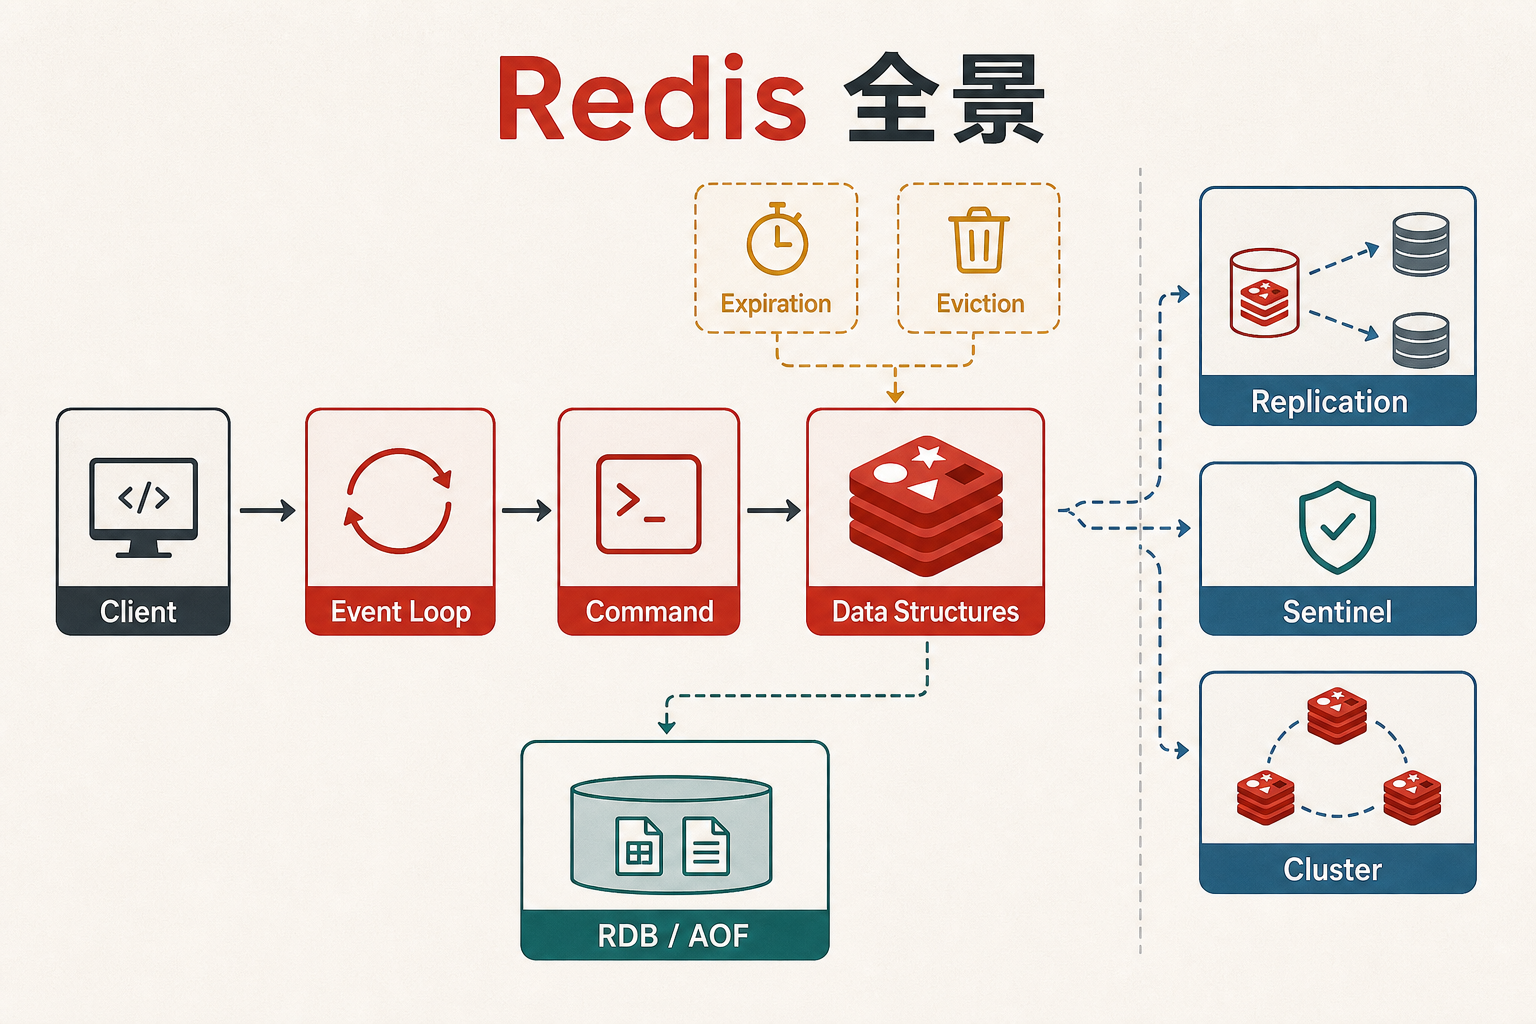
Event Loop、对象编码、RDB/AOF、Replication、Sentinel和Cluster分别解决什么;Cache-Aside为什么仍有旧值回填,分布式锁又为什么需要Fencing Token。
RAG
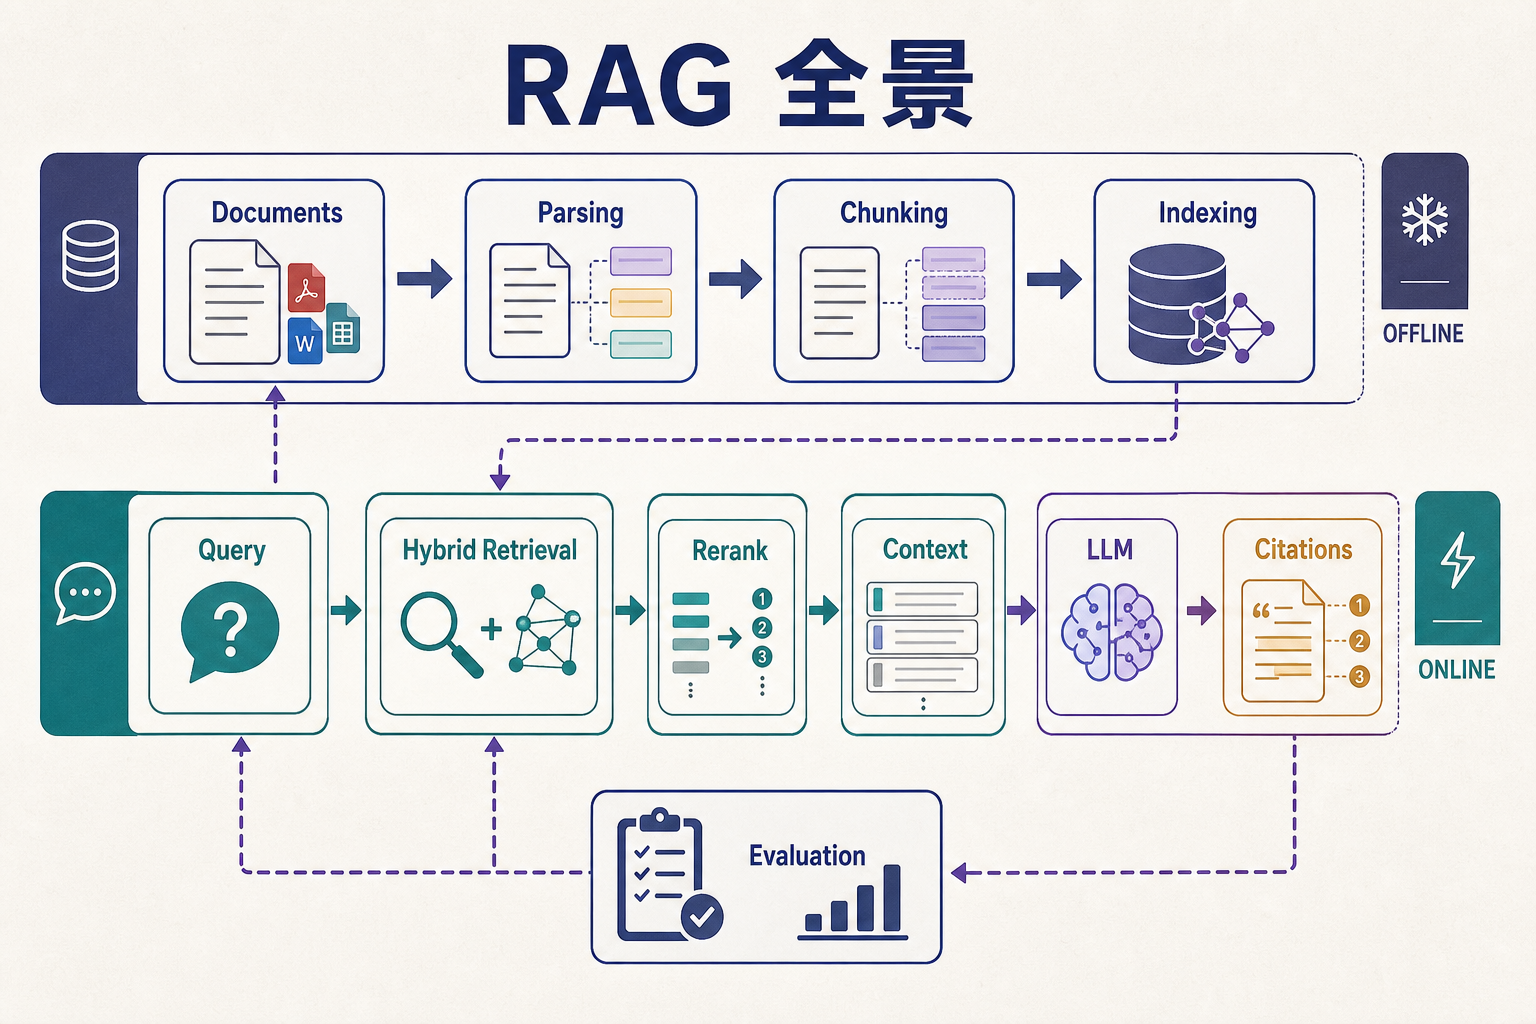
完整说明离线摄取、Chunk、BM25、Milvus、Neo4j、RRF、Cross-Encoder和Context Builder;重点不在于组件数量,而在于如何通过双索引版本、Citation和分层评测使答案可追溯。
四篇遵循同一分析原则:一个“成功”通常仅在特定边界内成立。PostgreSQL提交成功不等于副本已经完成流量切换,Kafka写入成功不等于业务处理成功,Redis更新成功不等于缓存与数据库严格一致,RAG生成成功也不等于答案正确。理解机制时,还需要明确其负责的可靠性边界。